محتويات المقال
اضغط على القسم الذي تريد قراءته للانتقال إليه مباشرة.
- ما هو محرك البحث وكيف يعمل باختصار؟ ↓
- ما أنواع محركات البحث وأشهر محركات البحث؟ ↓
- ما المراحل التي تمر بها الصفحة قبل ظهورها في نتائج البحث؟ ↓
- كيف تكتشف محركات البحث صفحات الويب؟ ↓
- ما هو الزحف Crawling وكيف يعمل Googlebot؟ ↓
- ما هو Rendering ولماذا يهم لمحركات البحث؟ ↓
- ما هي الفهرسة Indexing وكيف يفهم Google محتوى الصفحة؟ ↓
- ما هو Canonical وكيف يختار Google الصفحة الأساسية؟ ↓
- ماذا يحدث عندما تكتب عملية بحث في Google؟ ↓
- كيف ترتب محركات البحث نتائج البحث؟ ↓
- لماذا قد لا تظهر صفحة موقعك في Google؟ ↓
- كيف تعرف هل Google اكتشف وفهرس صفحتك؟ ↓
- ما علاقة SEO بطريقة عمل محركات البحث؟ ↓
- هل غيّر الذكاء الاصطناعي طريقة عمل محركات البحث؟ ↓
- الأسئلة الشائعة عن محركات البحث ↓
- الخاتمة: كيف تعمل محركات البحث وما الذي يجب أن تتذكره؟ ↓
مقدمة
نستخدم Google ومحركات البحث يوميًا للوصول إلى إجابة، خدمة أو منتج، لكن قليلًا ما نفكر في الخطوات التي تحدث بين كتابة كلمة البحث وظهور النتائج أمامنا خلال ثوانٍ.
وفهم كيف تعمل محركات البحث يساعدك على معرفة لماذا تظهر بعض الصفحات في النتائج بينما لا تظهر صفحات أخرى، وما الذي يحدث للمحتوى منذ لحظة اكتشافه وحتى وصوله إلى المستخدم.
في هذا الدليل سنشرح ببساطة كيف تعمل محركات البحث على شبكة الانترنت، والمراحل التي تمر بها صفحات المواقع، وكيف تحاول أنظمة البحث فهم المحتوى واختيار النتائج المناسبة لكل عملية بحث.
ما هو محرك البحث وكيف يعمل باختصار؟
إذا أردنا تعريف محرك البحث ببساطة، فهو نظام رقمي يساعد المستخدم على الوصول إلى المعلومات الموجودة على الإنترنت من خلال كتابة كلمة، سؤال أو استعلام بحث، ثم يعرض له مجموعة من النتائج التي يراها أكثر ارتباطًا بما يبحث عنه.
لكن محرك البحث لا يبدأ في تصفح شبكة الإنترنت بالكامل في اللحظة التي تضغط فيها على زر البحث. قبل ذلك، تعمل أنظمته باستمرار على اكتشاف صفحات الويب وجمع معلومات عنها وتنظيمها، حتى تستطيع الرجوع إليها بسرعة عندما يجري المستخدم عملية بحث.
وعندما تكتب سؤالًا في Google مثلًا، يحاول محرك البحث أولًا فهم ما الذي تقصده، ثم يبحث داخل المعلومات التي سبق له تنظيمها، ويقارن بين الصفحات التي يمكن أن تجيب عن طلبك، قبل أن يعرض النتائج بالترتيب الذي يراه أكثر ملاءمة وفائدة.
لذلك فإن تعريف محرك البحث لا يقتصر على كونه مربعًا نكتب فيه الكلمات، بل هو منظومة تجمع بين اكتشاف محتوى الويب، فهمه وتنظيمه، ثم استرجاع الصفحات المناسبة عندما يحتاج إليها المستخدم.
وفهم كيف تعمل محركات البحث يبدأ من معرفة ما يحدث خلف هذه العملية؛ فقبل أن تظهر أي صفحة أمام المستخدم، تمر بعدة مراحل تبدأ من اكتشافها وتنتهي بتحديد ما إذا كانت مناسبة للظهور في نتائج البحث، وهي المراحل التي سنشرحها بالتفصيل في الأجزاء التالية.
ما هو فهرس البحث Search Index؟
فهرس البحث أو Search Index هو قاعدة معلومات ضخمة ومنظمة تحتفظ فيها محركات البحث بالبيانات التي استطاعت فهمها عن صفحات الويب، حتى تتمكن من الرجوع إليها بسرعة عندما يجري المستخدم عملية بحث.
يمكن تشبيه الفهرس بمكتبة رقمية ضخمة؛ فبدلًا من أن يبدأ Google في تصفح الإنترنت بالكامل كل مرة يكتب فيها المستخدم سؤالًا، يعتمد على المعلومات التي سبق له جمعها وتنظيمها عن الصفحات التي يعرفها.
ولا يحتوي الفهرس على رابط الصفحة فقط، بل يمكن أن يتضمن معلومات تساعد محرك البحث على فهم محتواها، مثل موضوع الصفحة، النصوص الموجودة بها، الصور ومقاطع الفيديو وبعض البيانات المرتبطة بطريقة تنظيم المحتوى.
ومن المهم التفرقة بين الفهرسة Indexing وفهرس البحث Search Index: الفهرسة هي العملية التي يحلل خلالها محرك البحث الصفحة ويحاول فهم محتواها، أما فهرس البحث فهو النظام المنظم الذي يمكن الاحتفاظ بالمعلومات الناتجة عن هذه العملية داخله.
كذلك، مجرد اكتشاف محرك البحث لصفحة أو زحف الروبوت إليها لا يعني بالضرورة أنها ستصبح جزءًا من الفهرس؛ فقرار الفهرسة يأتي بعد تحليل الصفحة، وسنشرح هذه المرحلة بالتفصيل لاحقًا عندما نصل إلى Indexing.
ما هي خوارزميات البحث Search Algorithms؟
خوارزميات البحث أو Search Algorithms هي الأنظمة التي تستخدمها محركات البحث لفهم ما يكتبه المستخدم وتحديد الصفحات الموجودة في فهرس البحث التي يمكن أن تقدم له الإجابة الأكثر ارتباطًا بطلبه.
فإذا كان Search Index هو المكان الذي تحتفظ فيه محركات البحث بالمعلومات التي جمعتها عن صفحات الويب، فإن الخوارزميات هي التي تساعدها على الاختيار من بين هذه المعلومات عندما يبدأ المستخدم عملية بحث.
ولا تبحث الخوارزمية في الإنترنت بالكامل من البداية عند كل استعلام، بل تعمل على تحليل طلب المستخدم، ثم مقارنة الصفحات المناسبة الموجودة في الفهرس لتحديد أيها أكثر ارتباطًا بما يبحث عنه. ويوضح Lumar أن الهدف الأساسي من خوارزمية محرك البحث هو تقديم نتائج ذات صلة وجودة عالية تلبي استعلام المستخدم بأسرع صورة ممكنة.
ولا تعتمد هذه العملية على إشارة واحدة فقط؛ فمحركات البحث تستخدم مجموعة من الأنظمة والإشارات للمساعدة في تحديد النتائج المناسبة وترتيبها. لكننا لن ندخل في تفاصيل هذه العوامل الآن، لأننا سنشرح لاحقًا كيف تعمل محركات البحث على ترتيب نتائج البحث وما الذي يجعل صفحة تظهر قبل أخرى.
ما أنواع محركات البحث وأشهر محركات البحث؟
توجد أنواع محركات البحث المختلفة بحسب الطريقة التي تساعد بها المستخدم على الوصول إلى المعلومات، لكن عند الحديث عن البحث على الويب يمكن تبسيط الصورة إلى فئتين رئيسيتين: محركات البحث التقليدية، ومحركات البحث التي تعتمد على تقنيات الذكاء الاصطناعي لتقديم تجربة بحث أكثر تفاعلية.
محركات البحث التقليدية تجمع معلومات عن صفحات الويب وتنظمها داخل فهارس ضخمة، ثم تسترجع وترتب الصفحات المناسبة عندما يكتب المستخدم استعلامًا. وهذا هو النموذج الذي تقوم عليه محركات مثل Google وBing وغيرها، وهو النموذج الأساسي الذي نشرح من خلاله كيف تعمل محركات البحث في هذا الدليل.
أما محركات وأدوات البحث المعتمدة على الذكاء الاصطناعي، فقد تتعامل مع السؤال بصورة مختلفة؛ إذ يمكنها تحليل الاستعلام وتجميع المعلومات من مصادر متعددة ثم تقديم إجابة مباشرة أو محادثية بدل عرض قائمة من الروابط فقط. وقد أصبحت هذه التجربة جزءًا متزايدًا من مشهد البحث، لكننا سنتناولها بشكل مستقل في جزء لاحق من المقال.
وعند البحث عن أشهر محركات البحث التقليدية، نجد أسماء مثل Google وMicrosoft Bing، بالإضافة إلى Yahoo وBaidu وYandex، وتختلف درجة استخدام كل محرك حسب السوق والدولة والجمهور.
وتساعد هذه امثلة عن محركات البحث على فهم أن فكرة محرك البحث لا ترتبط بـGoogle وحده، حتى وإن كان هو الاسم الأكثر ارتباطًا بالبحث لدى كثير من المستخدمين. وفي الفقرة التالية سنركز بشكل مختصر على Google وBing كنموذجين يوضحان كيف يمكن أن تختلف محركات البحث فيما بينها.
Google وBing كأمثلة على محركات البحث
يُعد Google وMicrosoft Bing من أبرز امثلة عن محركات البحث التي تساعد المستخدمين على الوصول إلى صفحات الويب والمعلومات من خلال كتابة كلمة أو سؤال أو استعلام بحث.
ويعتمد Google على أنظمة تعمل باستمرار على اكتشاف صفحات الويب، معالجة محتواها وتنظيم المعلومات عنها، ثم استخدام أنظمة البحث لاختيار النتائج المناسبة عندما يجري المستخدم عملية بحث.
أما bing محرك بحث تابع لشركة Microsoft، ويؤدي الوظيفة الأساسية نفسها من خلال اكتشاف محتوى الويب وفهرسته ثم استرجاع النتائج التي يراها مناسبة لاستعلام المستخدم.
ولا يعني تشابه المراحل الأساسية أن Google وBing سيعرضان دائمًا النتائج نفسها؛ فلكل محرك فهرس البحث الخاص به وأنظمته وخوارزمياته، ولذلك قد تظهر صفحة في مركز متقدم في Google بينما تحصل على ترتيب مختلف في Bing لنفس عملية البحث. وهي نقطة يوضحها Linkawy عند الحديث عن اختلاف خوارزميات الترتيب بين المحركات.
ومن المهم لذلك فهم أن bing محرك بحث مستقل وليس مجرد واجهة تعرض نتائج Google، كما أن اختلاف المحركات يوضح أن ظهور الصفحة لا يعتمد فقط على وجودها على الإنترنت، بل على قدرة كل محرك على اكتشافها وفهمها وإضافتها إلى فهرسه ثم اختيارها عند البحث.
ما المراحل التي تمر بها الصفحة قبل ظهورها في نتائج البحث؟
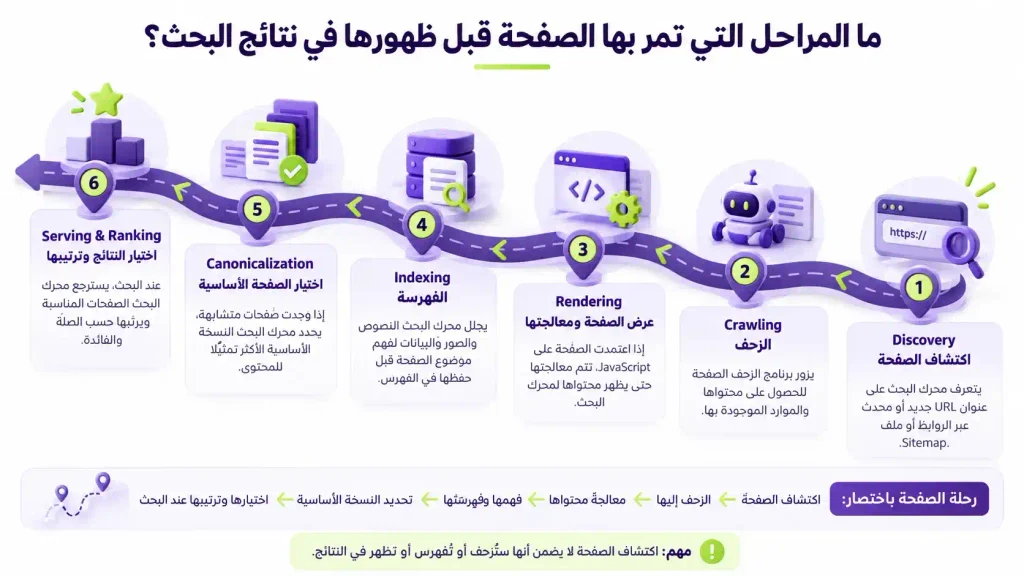
قبل أن تظهر صفحة من موقعك في نتائج البحث، لا تنتقل مباشرة من الإنترنت إلى Google. بل تمر بسلسلة من العمليات تبدأ بمعرفة محرك البحث بوجود الصفحة، ثم محاولة الوصول إليها وفهم محتواها، وتنتهي بتحديد ما إذا كانت مناسبة للظهور عندما يبحث المستخدم عن موضوع مرتبط بها.
وتعرض Google هذه العملية في ثلاث مراحل رئيسية: الزحف Crawling، الفهرسة Indexing، ثم عرض نتائج البحث Serving Search Results ، مع التأكيد على أن اكتشاف الصفحة لا يعني بالضرورة أنها ستنجح في الوصول إلى كل مرحلة.
ولفهم كيف تعمل محركات البحث بصورة أوضح، يمكن تفكيك رحلة الصفحة عمليًا إلى الخطوات التالية:
يتعرف محرك البحث أولًا على وجود عنوان URL جديد أو محدث، وقد يحدث ذلك من خلال رابط موجود في صفحة يعرفها بالفعل أو من خلال ملف Sitemap.
بعد اكتشاف الرابط، قد يزور برنامج الزحف الصفحة للحصول على محتواها والموارد الموجودة بها.
إذا كانت الصفحة تعتمد على JavaScript، يحتاج محرك البحث إلى معالجة الصفحة وعرض محتواها حتى يستطيع رؤية ما يظهر للمستخدم. Google يوضح أن عملية Rendering تحدث أثناء الزحف باستخدام نسخة حديثة من Chrome.
يحلل محرك البحث النصوص والصور والفيديو والبيانات المهمة الموجودة في الصفحة ويحاول فهم موضوعها، ثم يقرر ما إذا كانت معلوماتها مناسبة للحفظ داخل فهرسه.
إذا وجد محرك البحث عدة صفحات متشابهة، فقد يجمعها ويحدد الصفحة التي يعتبرها النسخة الأساسية أو الأكثر تمثيلًا للمحتوى.
عندما يكتب المستخدم استعلامًا، يبحث محرك البحث داخل فهرسه عن الصفحات المناسبة، ثم يستخدم أنظمته لتحديد النتائج الأكثر صلة وفائدة وترتيبها قبل عرضها للمستخدم.
إذن رحلة الصفحة يمكن تبسيطها كالتالي: اكتشاف الصفحة → الزحف إليها → معالجة محتواها → فهمها وفهرستها → تحديد النسخة الأساسية → اختيارها وترتيبها عند البحث.
والنقطة المهمة هنا أن الانتقال بين هذه الخطوات ليس مضمونًا تلقائيًا؛ فقد يعرف محرك البحث بوجود صفحة ولا يزحف إليها، أو يزحف إليها ولا يفهرسها، أو يفهرسها لكنها لا تظهر لعملية بحث معينة. Google يوضح صراحةً أن وجود الصفحة واتباع الإرشادات لا يضمن الزحف إليها أو فهرستها أو عرضها في النتائج.
كيف تكتشف محركات البحث صفحات الويب؟
قبل أن يتمكن محرك البحث من الزحف إلى صفحة جديدة، يجب أولًا أن يعرف أن هذه الصفحة موجودة. وتُعرف هذه الخطوة عادةً باسم اكتشاف عنوان URL أو URL Discovery.
فالإنترنت لا يحتوي على قائمة مركزية تضم كل الصفحات الموجودة عليه، ولذلك تعمل محركات البحث باستمرار على اكتشاف عناوين URL جديدة، بالإضافة إلى إعادة اكتشاف الصفحات التي سبق أن عرفتها لمعرفة ما إذا تم تحديثها. وتوضح Google أنها قد تكتشف صفحة جديدة عندما تجد رابطًا إليها داخل صفحة تعرفها بالفعل، أو عندما يتم إرسال عنوانها ضمن ملف Sitemap.
وهنا يظهر فرق مهم بين اكتشاف الصفحة والزحف إليها؛ فمعرفة محرك البحث بوجود عنوان URL لا تعني بالضرورة أنه زار الصفحة أو قرأ محتواها بعد. بعد اكتشاف الرابط، يقرر محرك البحث ما إذا كان سيزحف إليه ومتى سيقوم بذلك، وهي العملية التي سنشرحها بالتفصيل في قسم الزحف.
ولفهم كيف تعمل محركات البحث على شبكة الانترنت، تخيل أن محرك البحث يبني باستمرار خريطة ضخمة للويب. عندما يجد رابطًا يؤدي إلى صفحة لم يكن يعرفها، يضيف هذا العنوان إلى الصفحات التي أصبح على علم بوجودها، ثم يمكن لبرامج الزحف أن تزوره لاحقًا لجلب محتواه. وتوضح SpyFu وحسوب دور تتبع الروابط في انتقال برامج البحث من الصفحات المعروفة إلى صفحات جديدة.
ولا توجد وسيلة واحدة فقط لاكتشاف الصفحات؛ فقد يصل محرك البحث إلى URL من خلال رابط يشير إليه، أو من خلال Sitemap، أو لأنه سبق أن عرف الصفحة وزارها من قبل. ولهذا يمكن أن تكون لديك صفحة منشورة وتعمل بشكل طبيعي للمستخدمين، ومع ذلك لا يكون محرك البحث قد اكتشف عنوانها بعد. وفي الجزأين التاليين سنفصل أهم طريقتين تساعدان محركات البحث على الوصول إلى عناوين الصفحات: الروابط الموجودة بين صفحات الويب، ثم ملفات XML Sitemap.
الروابط الداخلية والخارجية
تُعد الروابط من أهم الطرق التي تساعد محركات البحث على اكتشاف صفحات جديدة على الويب. فعندما يصل برنامج الزحف إلى صفحة يعرفها بالفعل، يستطيع قراءة الروابط الموجودة بها واتباعها للوصول إلى عناوين URL أخرى لم يكن قد اكتشفها من قبل. وتوضح Google أنها قد تتعرف على صفحة جديدة من خلال رابط موجود داخل صفحة معروفة لديها.
الروابط الداخلية Internal Links هي الروابط التي تنقل المستخدم وبرامج الزحف من صفحة إلى أخرى داخل الموقع نفسه. فعلى سبيل المثال، عندما تربط صفحة قسم رئيسية بمقال جديد، يصبح هناك مسار يستطيع محرك البحث من خلاله الوصول إلى عنوان المقال واكتشاف وجوده. ولهذا تساعد بنية الربط الداخلي الجيدة محركات البحث على التنقل بين أجزاء الموقع والعثور على صفحاته. ويشير كل من Hsoub وSpyFu إلى دور الروابط الداخلية في مساعدة برامج البحث على الوصول إلى صفحات أخرى داخل الموقع.
أما الروابط الخارجية External Links، ففي سياق الاكتشاف هي روابط تنتقل من صفحة في موقع إلى عنوان URL موجود على موقع آخر. فإذا كان محرك البحث يعرف الصفحة التي تحتوي على الرابط، يمكنه اتباع هذا المسار واكتشاف الصفحة الموجودة في الموقع الآخر أيضًا. ويوضح For9a أن Googlebot يتتبع الروابط الداخلية والخارجية أثناء انتقاله بين صفحات الويب بحثًا عن محتوى جديد.
ويمكن تصور الأمر كشبكة مترابطة؛ فكل صفحة تحتوي على روابط يمكن أن تفتح أمام برنامج الزحف مسارات جديدة تؤدي إلى صفحات أخرى. لذلك تكون الصفحة المرتبطة بصفحات أخرى أسهل في الوصول إليها من صفحة لا يشير إليها أي رابط داخل الموقع أو خارجه.
لكن وجود رابط يؤدي إلى الصفحة لا يعني تلقائيًا أنها ستتم فهرستها؛ فالرابط يساعد محرك البحث على معرفة أن عنوان URL موجود والوصول إليه، بينما قرار الزحف إليه وفهم محتواه وفهرسته يعتمد على المراحل التي تأتي بعد الاكتشاف. Google تؤكد أن اكتشاف الصفحة لا يضمن بالضرورة الزحف إليها أو فهرستها.
ملفات XML Sitemap
ملف XML Sitemap هو ملف منظم يحتوي على عناوين الصفحات والملفات المهمة في الموقع، ويستخدمه محرك البحث كمصدر إضافي للتعرف على URLs التي يريد صاحب الموقع أن تكون قابلة للاكتشاف.
وتساعد خريطة الموقع محركات البحث على فهم بنية الموقع والوصول إلى الصفحات المهمة بصورة أكثر كفاءة، خاصة في المواقع الكبيرة، أو المواقع الجديدة التي لا تحصل بعد على روابط خارجية كثيرة، أو المواقع التي تحتوي على صفحات قد لا تكون مرتبطة جيدًا بباقي أجزاء الموقع. وتوضح Google أن Sitemap يمكن أن تساعد في تحسين اكتشاف الصفحات والزحف إليها، لكنها لا تضمن أن كل URL موجود بداخلها سيتم الزحف إليه أو فهرسته.
ويمكن أن يحتوي ملف Sitemap أيضًا على معلومات إضافية عن بعض الصفحات، مثل تاريخ آخر تحديث من خلال lastmod، كما يمكن استخدام امتدادات خاصة للصور والفيديو والأخبار. Google توضح أنها قد تستخدم قيمة lastmod عندما تكون دقيقة ومتسقة، بينما تتجاهل حاليًا قيم priority وchangefreq.
وتظهر أهمية XML Sitemap بشكل أكبر عندما تكون بعض الصفحات صعبة الاكتشاف عبر الروابط الداخلية وحدها. ففي هذه الحالة تعطي خريطة الموقع محرك البحث قائمة إضافية بعناوين URL التي ينبغي أن يعرف بوجودها، إلى جانب المسارات التي يكتشفها أثناء تتبع الروابط.
لكن وجود الصفحة داخل Sitemap لا يعني أن محرك البحث سيزورها أو يضيفها إلى الفهرس تلقائيًا؛ فهي إشارة تساعد على الاكتشاف والزحف، بينما تظل قرارات الزحف والفهرسة مرتبطة بعوامل أخرى في المراحل التالية. Google تصف إرسال Sitemap بأنه مجرد إشارة وليست ضمانًا لاستخدامها في الزحف أو الفهرسة.
ما هو الزحف Crawling وكيف يعمل Googlebot؟
الزحف أو Crawling هو العملية التي تزور خلالها برامج محركات البحث عناوين URL التي تعرف بوجودها لجلب محتوى الصفحات والموارد المرتبطة بها، حتى يمكن معالجة هذه المعلومات في المراحل التالية.
وفي Google، يُعرف برنامج الزحف الأساسي باسم Googlebot. فعندما يكون Google على علم بعنوان صفحة ما، يمكن لـGooglebot إرسال طلب إلى الخادم الذي يستضيفها، ثم جلب محتوى الصفحة وما يحتاج إليه من موارد لفهم ما يمكن الوصول إليه من خلالها. وتوضح Google أنها تستخدم عددًا ضخمًا من أجهزة الكمبيوتر لزيارة مليارات الصفحات على الويب.
ولا يزور Googlebot كل عنوان URL يكتشفه فورًا أو بنفس المعدل؛ إذ تعتمد عملية الزحف على أنظمة وخوارزميات تحدد المواقع التي ينبغي زيارتها، وعدد الصفحات التي يمكن جلبها منها، ومعدل تكرار الزيارات. كما تحاول Google ضبط سرعة الزحف حتى لا ترسل طلبات كثيرة يمكن أن تسبب ضغطًا زائدًا على خادم الموقع.
وتساعدنا هذه المرحلة على فهم كيف تعمل محركات البحث بصورة أدق؛ فبعد أن يعرف محرك البحث بوجود الصفحة، يحتاج إلى الوصول إليها فعليًا وجلب محتواها قبل أن يتمكن من تحليل هذا المحتوى واتخاذ قرار بشأن الفهرسة لاحقًا.
ولهذا يجب التفرقة بين الزحف Crawling والفهرسة Indexing. قد يزور Googlebot صفحة ويجلب محتواها، لكن ذلك لا يعني تلقائيًا أنها ستتم إضافتها إلى فهرس Google؛ فالفهرسة تأتي بعد الزحف وتتضمن تحليل الصفحة وفهم محتواها واتخاذ قرار بشأن تخزين معلوماتها. Google توضح أن بعض الصفحات لا تجتاز جميع مراحل البحث، وأن الزحف لا يضمن الفهرسة.
ما هي Crawlers وBots وSpiders؟
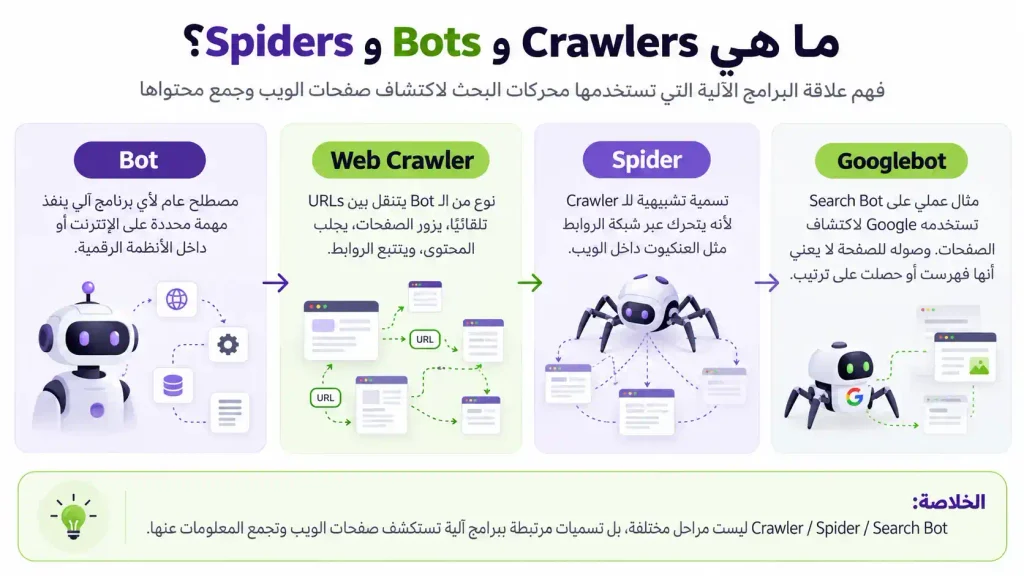
مصطلحات Crawlers وBots وSpiders تُستخدم عند الحديث عن البرامج الآلية التي تعتمد عليها محركات البحث لزيارة صفحات الويب، جلب محتواها والانتقال عبر الروابط الموجودة بينها.
ويُقصد بـ Web Crawler برنامج مصمم للتنقل بصورة آلية بين عناوين URL وجلب المعلومات الموجودة في الصفحات. ولهذا يُطلق عليه Crawler، أي «برنامج زحف»، لأنه ينتقل تدريجيًا من صفحة إلى أخرى عبر شبكة الويب.
أما مصطلح Spider أو «عنكبوت الويب» فهو تسمية تشبيهية لنفس الفكرة؛ فالبرنامج يتحرك عبر الروابط التي تربط صفحات الإنترنت ببعضها كما يتحرك العنكبوت داخل شبكة مترابطة. ويستخدم For9a المصطلحات Web Crawlers وSpiders وBots عند شرح الروبوتات التي تستخدمها محركات البحث في عملية الزحف.
أما Bot فهو مصطلح أوسع يشير بشكل عام إلى برنامج يقوم بمهام آلية دون تدخل بشري مستمر. لذلك يمكن اعتبار Crawler نوعًا من الـBots عندما تكون مهمته تصفح صفحات الويب وجلب محتواها لمحرك البحث.
ومن أشهر الأمثلة Googlebot، وهو الاسم الذي تستخدمه Google لبرامج الزحف التابعة لها. لكن وجود Googlebot في صفحة ما لا يعني أن هذه الصفحة أصبحت مفهرسة أو حصلت على ترتيب؛ فوظيفة برنامج الزحف في هذه المرحلة هي الوصول إلى المحتوى وجلبه، بينما تأتي معالجة الصفحة والفهرسة والترتيب في مراحل أخرى.
وبالتالي، عندما تقابل مصطلحات Crawler أو Spider أو Search Bot داخل موضوعات محركات البحث، فهي لا تشير عادةً إلى ثلاث مراحل مختلفة، بل إلى تسميات مرتبطة بالبرامج الآلية التي تتولى عملية التنقل وجمع صفحات الويب.
ما الذي قد يمنع محرك البحث من الزحف؟
حتى إذا اكتشف Google عنوان URL، فقد لا يتمكن Googlebot من الوصول إلى الصفحة أو جلب محتواها بصورة طبيعية. ويمكن أن يحدث ذلك بسبب مجموعة من القيود أو المشكلات التقنية في الموقع.
من أبرز هذه الأسباب ملف robots.txt. يستطيع صاحب الموقع من خلال هذا الملف تحديد أجزاء لا يُسمح لبعض برامج الزحف بالوصول إليها. فإذا كان مسار صفحة محظورًا عن Googlebot باستخدام Disallow، فلن يزحف Google إلى محتوى هذه الصفحة بصورة طبيعية. وتوضح Google أن قواعد robots.txt تحدد الأجزاء التي يُسمح لبرامج الزحف بالوصول إليها.
وقد يتعذر الزحف أيضًا عندما تكون الصفحة محمية بتسجيل دخول أو صلاحيات وصول لا يستطيع Googlebot تجاوزها. فإذا كان المستخدم يحتاج إلى تسجيل الدخول لرؤية المحتوى، فلن يتمكن محرك البحث في العادة من الوصول إلى المحتوى نفسه كما يصل إليه المستخدم المسجل. ويشير SpyFu إلى الصفحات التي تتطلب Login كأحد الأمثلة الشائعة على الصفحات التي لا يستطيع برنامج الزحف الوصول إليها.
كما يمكن أن تمنع مشكلات الخادم أو الشبكة Googlebot من جلب الصفحة. فإذا تعذر اتصال Google بالخادم، أو انتهت مهلة الاتصال، أو استمر الموقع في إرجاع أخطاء 5xx، فلن يحصل برنامج الزحف على المحتوى المطلوب في تلك المحاولة. Google تتعامل أيضًا مع مشكلات DNS والشبكة وانقطاع الاتصال باعتبارها أخطاء في الخادم عند التعامل مع عملية الزحف.
وقد تؤثر كذلك مشكلات مثل Redirect Loops أو بنية الموقع السيئة والروابط المكسورة في قدرة برامج البحث على الوصول بكفاءة إلى صفحات الموقع. وتضع Semrush هذه المشكلات ضمن أبرز أسباب ضعف قابلية المواقع للزحف.
لكن من المهم عدم الخلط بين منع الزحف ومنع الفهرسة. فعلامة noindex لا تمنع Googlebot من زيارة الصفحة؛ بل تطلب من محرك البحث عدم الاحتفاظ بها في نتائج البحث بعد أن يتمكن من الزحف إليها ورؤية التوجيه. لذلك قد تكون الصفحة قابلة للزحف بالكامل، لكنها غير قابلة للفهرسة.
وبالتالي، إذا كان محرك البحث يعرف بوجود URL لكنه لا يستطيع جلب محتواه، فالمشكلة ما زالت في مرحلة Crawling. أما إذا استطاع جلب الصفحة بالفعل، فننتقل إلى الخطوة التالية: كيف يعالج محرك البحث الصفحة ويرى المحتوى الذي يظهر للمستخدم.
ما هو Rendering ولماذا يهم لمحركات البحث؟
بعد أن يجلب Googlebot الصفحة ومواردها، قد يحتاج محرك البحث إلى خطوة إضافية حتى يرى الصفحة بالطريقة الأقرب لما يراه المستخدم. تُعرف هذه العملية باسم Rendering، أي معالجة الصفحة وتشغيل ما يلزم من JavaScript لبناء المحتوى النهائي الذي يمكن تحليله.
توضح Google أنها تستخدم Web Rendering Service يعتمد على نسخة حديثة من Chromium لمعالجة الصفحات. وفي المواقع التقليدية قد يكون معظم المحتوى موجودًا بالفعل في HTML الذي يستلمه Googlebot، بينما تعتمد بعض المواقع الحديثة على JavaScript لإظهار أجزاء أساسية من الصفحة بعد التحميل.
أهمية Rendering تظهر عندما يكون النص أو الروابط أو العناصر المهمة غير موجودة في الاستجابة الأولية للصفحة، وإنما تُنشأ بعد تنفيذ JavaScript. في هذه الحالة يحتاج Google إلى معالجة الصفحة حتى يستطيع رؤية هذا المحتوى قبل استخدامه في الفهرسة.
ولهذا لا يكفي أن تبدو الصفحة سليمة في متصفح المستخدم فقط؛ المهم أيضًا أن يستطيع Google جلب الموارد اللازمة ومعالجة الصفحة ورؤية المحتوى الأساسي الذي تريد أن يفهمه.
كيف تتعامل Google مع JavaScript؟
تستطيع Google تشغيل JavaScript في صفحات الويب، لذلك استخدام JavaScript لا يعني تلقائيًا أن المحتوى لن يظهر في البحث. بعد جلب الصفحة، يمكن وضعها في قائمة انتظار Rendering ثم تشغيل JavaScript باستخدام بيئة مبنية على Chromium.
بعد تنفيذ JavaScript، يعيد Google تحليل الـHTML الناتج، ويمكنه العثور على نصوص وروابط لم تكن موجودة في الاستجابة الأولية. وتستخدم Google هذا المحتوى الناتج عن Rendering عند تقييم الصفحة للفهرسة.
لكن نجاح العملية يعتمد على أن تكون ملفات JavaScript وCSS والموارد الضرورية قابلة للوصول، وأن يعمل الكود بطريقة متوافقة مع بيئة Google. لذلك يظل توفير المحتوى الأساسي بصورة واضحة وقابلة للوصول خيارًا أكثر أمانًا من الاعتماد على تنفيذ معقد حتى تظهر أهم معلومات الصفحة.
ماذا يحدث إذا لم يستطع Google رؤية المحتوى؟
إذا لم يظهر جزء مهم من الصفحة في المحتوى الذي يستطيع Google معالجته، فقد لا يتمكن محرك البحث من الاعتماد عليه عند فهم الصفحة. ويشمل ذلك النصوص الأساسية أو الروابط أو البيانات التي لا تظهر إلا بعد عملية JavaScript تفشل أثناء Rendering.
قد يحدث ذلك بسبب حظر ملفات ضرورية، أخطاء JavaScript، طلبات تعتمد على خدمات لا يستطيع Google الوصول إليها، أو لأن التطبيق يعرض للمستخدم محتوى لا يظهر في الـRendered HTML الذي يراه محرك البحث.
ولهذا يمكن استخدام URL Inspection في Search Console لفحص الصفحة ورؤية المعلومات التي استطاع Google الوصول إليها. فإذا كان المحتوى الأساسي ظاهرًا للمستخدم لكنه غير موجود في النسخة التي يعالجها Google، فالمشكلة تحتاج إلى إصلاح قبل الانتقال بثقة إلى مرحلة الفهرسة.
ما هي الفهرسة Indexing وكيف يفهم Google محتوى الصفحة؟
بعد أن يتمكن Google من جلب الصفحة ومعالجة محتواها، تبدأ مرحلة الفهرسة أو Indexing. في هذه المرحلة يحلل محرك البحث ما تحتويه الصفحة ويحاول فهم موضوعها والعناصر الموجودة بها وعلاقتها بصفحات أخرى.
توضح Google أنها تحلل النصوص والعناصر المهمة في الصفحة، بالإضافة إلى الصور والفيديو عند توفرها، ثم تجمع المعلومات التي تساعدها على فهم المحتوى. وإذا وجدت صفحات متشابهة جدًا، يمكن أن تجمعها معًا وتحدد الصفحة التي تعتبرها النسخة الأساسية.
إذا قررت أن الصفحة مناسبة للفهرسة، يمكن تخزين المعلومات عنها داخل Search Index حتى تصبح مؤهلة للاسترجاع عندما يبحث المستخدم عن موضوع مرتبط بها.
لكن الفهرسة ليست خطوة مضمونة لكل صفحة تم الزحف إليها؛ فالصفحة قد تكون قابلة للوصول ومع ذلك يقرر Google عدم إضافتها إلى الفهرس.
كيف يفهم Google النصوص والعناوين والصور والفيديو؟
لفهم موضوع الصفحة لا يعتمد Google على عنصر واحد فقط. فهو يحلل النص الرئيسي والعناوين الموجودة في الصفحة، ويراجع العناصر التي تساعد على تحديد بنية المحتوى ومعناه.
كما يمكن أن يستخدم المعلومات المرتبطة بالصور والفيديو، مثل النص المحيط بها والبيانات الوصفية المناسبة، لفهم دور هذه العناصر داخل الصفحة. وتساعد العناوين الواضحة والتنظيم المنطقي للمحتوى على توضيح العلاقة بين أجزاء الموضوع.
لهذا لا تعني الفهرسة البحث عن كلمة مفتاحية ثم تخزين الصفحة بسبب وجودها؛ بل محاولة تكوين صورة أوسع عما تقدمه الصفحة وما إذا كان محتواها مفهومًا ومناسبًا للاستخدام لاحقًا في البحث.
هل كل صفحة يتم الزحف إليها تُفهرس؟
لا. وصول Googlebot إلى الصفحة وجلب محتواها لا يعني أن Google سيضيفها تلقائيًا إلى الفهرس. Google يوضح أن الصفحات لا تمر بالضرورة بجميع مراحل البحث حتى لو كان الوصول إليها ممكنًا.
قد تمنع تعليمات مثل noindex الفهرسة، وقد يرى Google أن هناك نسخة أخرى أكثر تمثيلًا للمحتوى، أو أن الصفحة لا تقدم قيمة كافية أو تحتوي على مشكلات تجعل إضافتها إلى الفهرس غير مناسبة.
ولهذا فإن حالة Crawled لا تساوي Indexed. الأولى تعني أن Google استطاع جلب الصفحة، بينما الثانية تعني أن معلومات الصفحة أصبحت ضمن الفهرس ويمكن أن تكون مؤهلة للظهور في نتائج البحث.
المحتوى المكرر والصفحات منخفضة القيمة
وجود محتوى مكرر لا يعني تلقائيًا وجود عقوبة. عندما يجد Google عدة URLs تحتوي على محتوى متطابق أو شديد التشابه، يمكنه تجميعها واختيار نسخة أساسية تمثل هذا المحتوى.
لكن كثرة الصفحات المتشابهة، أو الصفحات التي لا تقدم معلومات واضحة أو مفيدة، قد تجعل Google لا يرى ضرورة لفهرسة كل نسخة منها. وتذكر Google أن انخفاض جودة محتوى الصفحة يمكن أن يكون أحد أسباب مشكلات الفهرسة.
لذلك الأفضل أن يكون لكل صفحة هدف واضح وقيمة مستقلة، وأن يتم استخدام إشارات Canonical المناسبة عندما توجد نسخ متعددة من المحتوى نفسه.
ما هو Canonical وكيف يختار Google الصفحة الأساسية؟
عندما يجد Google عدة عناوين URL تعرض المحتوى نفسه أو محتوى شديد التشابه، يحاول تجميع هذه الصفحات واختيار عنوان واحد يعتبره النسخة الأساسية أو Canonical.
تسمى هذه العملية Canonicalization. وتساعد Google على تقليل التكرار وتحديد الصفحة التي ستُستخدم عادةً كمصدر رئيسي لفهم المحتوى وعرضه في نتائج البحث.
يمكن لصاحب الموقع إرسال إشارات تساعد Google على معرفة النسخة المفضلة، مثل Redirects ووسم rel="canonical" وإدراج URL في Sitemap. لكن Google يوضح أن هذه الإشارات لا تفرض الاختيار بصورة مطلقة، وقد يحدد عنوانًا مختلفًا إذا رأته أنظمته أكثر تمثيلًا.
ولهذا يجب أن تكون إشارات الموقع متناسقة: الروابط الداخلية وCanonical والـSitemap والتحويلات ينبغي قدر الإمكان أن تشير إلى النسخة التي تريد اعتبارها الصفحة الأساسية.
ماذا يحدث عندما تكتب عملية بحث في Google؟
عندما يكتب المستخدم كلمة أو سؤالًا في Google، لا يبدأ محرك البحث في تصفح الإنترنت بالكامل في تلك اللحظة. بدلًا من ذلك، تعمل أنظمته على فهم الاستعلام ثم البحث داخل الفهرس عن الصفحات التي يمكن أن تكون مناسبة له.
بعد ذلك تُقارن الصفحات المرشحة باستخدام أنظمة ترتيب آلية تحاول تحديد النتائج الأكثر صلة وفائدة لذلك البحث. وتتم هذه العملية في أجزاء من الثانية رغم أن الفهرس يحتوي على كميات هائلة من المعلومات.
والنتيجة التي يراها المستخدم ليست مجرد قائمة بالصفحات التي تحتوي على الكلمات نفسها؛ إذ تحاول أنظمة البحث فهم المقصود من الاستعلام والسياق المرتبط به ثم اختيار شكل النتائج والصفحات الأنسب.
كيف يفهم محرك البحث Query المستخدم؟
أول ما تحتاج أنظمة البحث إلى فعله هو تفسير ما الذي يريده المستخدم من الاستعلام. وقد يكون الاستعلام كلمة قصيرة، سؤالًا كاملًا، اسم منتج أو طلبًا مرتبطًا بمكان أو وقت.
تستخدم Google أنظمة متعددة لفهم الكلمات وعلاقتها بالمفاهيم، ولذلك يمكنها العثور على محتوى مرتبط بالمعنى حتى إذا لم تستخدم الصفحة والاستعلام الكلمات نفسها حرفيًا.
كما يمكن أن تختلف أهمية بعض الإشارات حسب طبيعة البحث؛ فالحداثة مثلًا تصبح أكثر أهمية في الأخبار والأحداث الجارية مقارنة بسؤال ثابت لا يتغير مع الوقت.
كيف يبحث Google داخل Search Index؟
بعد فهم الاستعلام، تبحث أنظمة Google داخل Search Index عن الصفحات التي يمكن أن تقدم معلومات مرتبطة بما يريده المستخدم.
الفهرس يحتوي على معلومات تم جمعها وتحليلها مسبقًا عن صفحات الويب، ولذلك يستطيع محرك البحث استرجاع مجموعة من الصفحات المرشحة بسرعة بدل إعادة زيارة الإنترنت كله عند كل عملية بحث.
بعد تكوين هذه المجموعة تبدأ أنظمة الترتيب في المقارنة بين النتائج المحتملة لتحديد أي الصفحات ينبغي أن تظهر وأيها يجب أن تحصل على مراكز أعلى.
كيف يطابق Google الصفحات مع Search Intent؟
Search Intent تعبر عن الهدف الذي يحاول المستخدم الوصول إليه من عملية البحث. فقد يريد معلومة، موقعًا محددًا، مقارنة بين خيارات، أو تنفيذ إجراء مثل شراء منتج أو التواصل مع شركة.
تحاول أنظمة البحث اختيار محتوى يتناسب مع هذا الهدف، ولذلك قد تختلف أنواع النتائج التي تظهر باختلاف طبيعة الاستعلام. فالبحث المحلي قد يعرض نتائج وخرائط محلية، بينما قد يدفع استعلام بصري إلى ظهور صور أو فيديو بصورة أكبر.
ولا يلزم أن يكون لكل Query هدف واحد صارم؛ بعض عمليات البحث تحتمل أكثر من تفسير، ولذلك قد تعرض صفحة النتائج أنواعًا مختلفة من المحتوى حتى تغطي أكثر من احتياج محتمل.
كيف ترتب محركات البحث نتائج البحث؟
لفهم كيف تعمل محركات البحث على ترتيب نتائج البحث، من المهم معرفة أن Google لا يعتمد على عامل واحد أو معادلة بسيطة معلنة. تستخدم أنظمة الترتيب مجموعة كبيرة من الإشارات والعوامل لمقارنة الصفحات الموجودة في الفهرس وتحديد النتائج الأكثر صلة وفائدة.
تختلف أهمية هذه الإشارات حسب طبيعة Query. فقد تصبح حداثة المحتوى مهمة جدًا عند البحث عن خبر حديث، بينما تكون عوامل أخرى أكثر تأثيرًا عندما يبحث المستخدم عن تعريف أو دليل ثابت.
وتعمل أنظمة Google غالبًا على مستوى الصفحة، مع وجود بعض الإشارات والتقييمات التي يمكن أن ترتبط بالموقع ككل. لذلك لا يعني قوة موقع معين أن كل صفحة فيه ستحصل تلقائيًا على ترتيب مرتفع.
ويمكن تبسيط أهم الجوانب التي تدخل في اختيار النتائج إلى مدى الصلة بالبحث، جودة وفائدة المحتوى، تجربة استخدام الصفحة، والسياق المرتبط بالمستخدم والاستعلام.
مدى صلة الصفحة بعملية البحث
من أول الأسئلة التي تحاول أنظمة الترتيب الإجابة عنها: هل هذه الصفحة مرتبطة فعلًا بما يبحث عنه المستخدم؟ ويشمل ذلك الكلمات والمفاهيم الموجودة في المحتوى ومدى توافق الموضوع مع معنى الاستعلام.
وجود الكلمات المستخدمة في البحث يمكن أن يساعد محرك البحث على فهم الصلة، لكنه ليس كافيًا وحده. فقد تحتوي صفحة على العبارة نفسها مرات كثيرة من دون أن تقدم إجابة مناسبة، بينما تكون صفحة أخرى أكثر ارتباطًا بالمعنى والهدف حتى باستخدام صياغات مختلفة.
لذلك تبدأ الصلة من تقديم محتوى يعالج السؤال أو الحاجة التي تقف خلف Query بشكل مباشر وواضح.
جودة وفائدة المحتوى
بعد التأكد من أن الصفحة مرتبطة بالموضوع، تحتاج أنظمة البحث إلى تقييم ما إذا كان المحتوى مفيدًا وموثوقًا بما يكفي ليخدم المستخدم.
توصي Google بإنشاء محتوى مفيد وموثوق وموجه للناس أولًا، وأن يعكس معرفة حقيقية بالموضوع بدل إنتاج صفحات هدفها الأساسي جذب زيارات من محركات البحث.
وتختلف معايير الجودة بحسب نوع الموضوع. فالصفحات التي تتناول قرارات حساسة تحتاج إلى مستوى أعلى من الثقة والدقة مقارنة بموضوع ترفيهي بسيط، كما يمكن أن تساعد الخبرة الأصلية والمصادر الواضحة والمعلومات الدقيقة على بناء محتوى أقوى.
قابلية استخدام الصفحة وتجربة المستخدم
تسعى أنظمة Google أيضًا إلى مكافأة الصفحات التي تقدم تجربة جيدة للمستخدم. وتشمل تجربة الصفحة جوانب مثل الأداء، الاستجابة، الاستقرار البصري، الأمان وسهولة الاستخدام على الأجهزة المختلفة.
تستخدم Google إشارات مرتبطة بـCore Web Vitals ضمن أنظمة الترتيب، لكنها تؤكد أنه لا توجد إشارة واحدة باسم Page Experience تحسم الترتيب، وأن الحصول على درجات ممتازة في أدوات الأداء لا يضمن المركز الأول.
فالصفحة الأسرع ليست بالضرورة أفضل نتيجة إذا كان محتواها أقل ارتباطًا أو فائدة. الأفضل هو الجمع بين محتوى مناسب وتجربة لا تعيق المستخدم عن الوصول إليه.
الموقع واللغة والجهاز وسياق البحث
لا تعتمد النتائج على الصفحة وحدها؛ فقد تستخدم Google معلومات مثل الموقع الجغرافي واللغة ونوع الجهاز وبعض إعدادات المستخدم لتقديم نتيجة أكثر مناسبة للسياق.
فعند البحث عن خدمة محلية يمكن أن يختلف ترتيب النتائج من مدينة إلى أخرى، بينما قد يؤدي اختلاف اللغة أو الجهاز إلى تغير نوع الصفحة أو الشكل الأنسب للعرض.
وتوضح هذه النقطة لماذا يمكن أن يرى مستخدمان نتائج مختلفة نسبيًا لنفس الكلمات، خصوصًا في عمليات البحث التي تعتمد بقوة على الموقع أو السياق.
لماذا قد لا تظهر صفحة موقعك في Google؟
عدم ظهور صفحة في Google لا يعني دائمًا وجود المشكلة نفسها. لتشخيص السبب بصورة صحيحة يجب تحديد المرحلة التي توقفت عندها الصفحة داخل رحلة البحث.
قد يكون Google لم يكتشف URL أصلًا، أو اكتشفه لكنه لم يزحف إليه بعد، أو زحف إليه لكنه لم يضفه إلى الفهرس، أو قد تكون الصفحة مفهرسة بالفعل لكنها لا تظهر للاستعلام الذي تختبره.
التمييز بين هذه الحالات مهم لأن حل كل واحدة مختلف؛ فلا فائدة مثلًا من تعديل محتوى صفحة إذا كان Google لا يعرف رابطها أصلًا، كما أن إعادة إرسال Sitemap لن تعالج بالضرورة صفحة ضعيفة تم الزحف إليها ورفض فهرستها.
URL غير مكتشف
إذا كان URL غير مكتشف، فهذا يعني أن Google لا يعرف بوجود الصفحة بعد. قد يحدث ذلك عندما تكون الصفحة جديدة ولا توجد روابط داخلية أو خارجية تشير إليها، ولا تظهر ضمن Sitemap يستطيع Google الوصول إليها.
في هذه الحالة تكون الأولوية لإنشاء مسار اكتشاف واضح: ربط الصفحة من صفحات مناسبة داخل الموقع والتأكد من وجودها في Sitemap عند الحاجة.
وجود الصفحة على الخادم وحده لا يرسل إشعارًا تلقائيًا إلى Google بأنها موجودة.
تم اكتشافها ولكن لم يتم الزحف إليها
قد يعرف Google عنوان الصفحة لكنه لم يرسل Googlebot لجلب محتواها بعد. تظهر هذه الحالة في Search Console أحيانًا بصيغة Discovered - currently not indexed.
لا تعني الحالة بالضرورة وجود خطأ داخل الصفحة نفسها؛ فقد يؤجل Google الزحف بسبب أولويات الزحف، حجم الموقع، قدرة الخادم أو تقييمه للحاجة إلى زيارة URL في الوقت الحالي.
هنا يجب مراجعة بنية الروابط الداخلية، استقرار الخادم، حجم الصفحات غير المهمة التي يستهلك الموقع الزحف فيها، ومدى أهمية الصفحة داخل هيكل الموقع بدل الاكتفاء بطلب الفهرسة بصورة متكررة.
تم الزحف إليها ولكن لم تتم فهرستها
إذا تم الزحف إلى الصفحة ولكنها لم تُفهرس، فهذا يعني أن Google استطاع الوصول إلى المحتوى لكنه لم يقرر الاحتفاظ بالصفحة في الفهرس.
قد يرجع ذلك إلى noindex، أو اختيار URL آخر كـCanonical، أو تشابه الصفحة بدرجة كبيرة مع صفحات أخرى، أو أن المحتوى لا يقدم قيمة كافية مقارنة بما يعرفه Google بالفعل.
في هذه الحالة لا يكون الحل مجرد طلب الفهرسة مرة بعد مرة، بل مراجعة سبب عدم استحقاق الصفحة للفهرسة والتأكد من أن لها هدفًا واضحًا ومحتوى مستقلًا وإشارات تقنية متناسقة.
الصفحة مفهرسة ولكن لا تظهر للاستعلام
يمكن أن تكون الصفحة موجودة بالفعل في فهرس Google ومع ذلك لا تراها عند البحث عن كلمة معينة. الفهرسة تعني أن Google يعرف الصفحة ويستطيع استخدامها، لكنها لا تضمن اختيارها لكل استعلام.
قد تكون صفحات أخرى أكثر ارتباطًا بالبحث أو أكثر فائدة، وقد يكون Query لا يتوافق مع الهدف الذي تعالجه الصفحة، أو قد تمنع بعض تعليمات العرض ظهور النتيجة في سياق معين.
هنا تنتقل المشكلة من Crawling وIndexing إلى Relevance وRanking: هل الصفحة فعلًا أفضل إجابة مناسبة لهذا البحث مقارنة بالبدائل الموجودة في الفهرس؟
كيف تعرف هل Google اكتشف وفهرس صفحتك؟
أفضل مكان لفحص حالة صفحة محددة في Google هو Search Console، لأنه يعرض معلومات مباشرة عن URL من منظور Google بدل الاعتماد على التخمين من نتائج البحث.
يمكنك استخدام URL Inspection لمعرفة ما إذا كان Google يعرف الصفحة، وما إذا كانت مفهرسة، وما هو Canonical الذي اختاره، بالإضافة إلى معلومات عن آخر عملية زحف وبعض المشكلات التي قد تؤثر في الفهرسة.
ويجب الانتباه إلى أن الاختبار المباشر Live Test يوضح إمكانية وصول Google إلى الصفحة في اللحظة الحالية، لكنه لا يضمن أن الصفحة ستُفهرس؛ فبعض قرارات الفهرسة مثل اختيار Canonical لا يمكن التنبؤ بها بالكامل من الاختبار المباشر.
Google Search Console وURL Inspection
داخل Search Console، اكتب عنوان الصفحة كاملًا في URL Inspection. ستعرض لك الأداة ما إذا كان URL موجودًا في Google، وحالة الفهرسة، والصفحة الأساسية التي اختارتها Google عند توفر البيانات.
إذا عدلت الصفحة، يمكنك إجراء Live Test للتأكد من أن Google يستطيع الوصول إلى النسخة الحالية، ثم استخدام Request Indexing لإرسال طلب لإعادة المعالجة.
لكن Request Indexing ليس ضمانًا للفهرسة أو الترتيب؛ فهو يطلب من Google إعادة النظر في URL، بينما يظل القرار النهائي خاضعًا لأنظمة الزحف والفهرسة.
الفرق بين اكتشاف الصفحة وفهرستها وظهورها
اكتشاف الصفحة يعني أن Google أصبح يعرف أن URL موجود، لكنه قد لا يكون زحف إليه بعد.
فهرسة الصفحة تعني أن Google عالج محتواها واحتفظ بمعلومات عنها داخل الفهرس، لكنها لا تضمن ظهورها لكل عملية بحث.
أما الظهور في النتائج فيحدث عندما تكون الصفحة مؤهلة ويختارها نظام البحث كإحدى النتائج المناسبة للاستعلام. لذلك يمكن تلخيص العلاقة في أن Discovery يسبق Crawling، والفهرسة تأتي بعد المعالجة، ثم تأتي مرحلة الاختيار والترتيب عند البحث.
ما علاقة SEO بطريقة عمل محركات البحث؟
تظهر قيمة SEO عندما تربط كل تحسين بمرحلة من مراحل عمل محرك البحث. فالروابط الداخلية وSitemap تساعد على الاكتشاف، وتوضح إرشادات Google للروابط القابلة للزحف أهمية أن تكون الروابط مفهومة وقابلة للاكتشاف، والإعدادات التقنية تساعد على الزحف والمعالجة، والمحتوى الواضح يساعد Google على الفهم والفهرسة، بينما الصلة والجودة وتجربة الصفحة تساعد في المنافسة عند ترتيب النتائج.
لهذا فإن فهم ما هو السيو بصورة صحيحة يوضح أنه لا يعني كتابة كلمات مفتاحية فقط، ولا توجد خطوة واحدة تجعل الصفحة تتصدر تلقائيًا. هو مجموعة تحسينات تجعل الموقع أسهل في الاكتشاف والفهم وأكثر فائدة للمستخدم.
وتوضح Google في Search Essentials أن النجاح يبدأ من تلبية المتطلبات التقنية، تجنب ممارسات Spam، إنشاء محتوى مفيد وموثوق، استخدام الكلمات التي يبحث بها الناس في أماكن وصفية مناسبة، وجعل الروابط قابلة للزحف.
وبالتالي فإن فهم مراحل البحث يجعل قرارات SEO أكثر دقة؛ لأنك تستطيع تحديد هل المشكلة في الاكتشاف، الزحف، Rendering، الفهرسة أم في قدرة الصفحة على المنافسة عند عرض النتائج. وبعد فهم هذه المراحل، يمكنك الانتقال إلى خطوات التنفيذ في دليل أفضل طرق لرفع مستوى أداء تحسين محركات البحث لموقعك على الويب.
هل غيّر الذكاء الاصطناعي طريقة عمل محركات البحث؟
غيّر الذكاء الاصطناعي شكل بعض تجارب البحث، لكنه لم يُلغِ الأساس الذي شرحناه في هذا الدليل. Google يستخدم الآن ميزات مثل AI Overviews وAI Mode لتجميع المعلومات ومساعدة المستخدم على استكشاف أسئلة أكثر تعقيدًا.
قد تستخدم هذه التجارب أسلوب Query Fan-out، حيث تُجرى عمليات بحث مرتبطة بموضوعات فرعية ومصادر متعددة للمساعدة في بناء الإجابة وإظهار روابط داعمة.
لكن Google يوضح أن الظهور كرابط داعم في AI Overviews أو AI Mode لا يحتاج إلى متطلبات SEO خاصة إضافية؛ يجب أن تكون الصفحة مفهرسة ومؤهلة للظهور في Google Search، مع استمرار أهمية الممارسات الأساسية نفسها مثل المحتوى المفيد والموثوق وقابلية الزحف والفهرسة.
لذلك تغير شكل النتائج وطريقة تفاعل المستخدم معها، بينما ما زالت القدرة على اكتشاف المحتوى وفهمه وفهرسته جزءًا أساسيًا من الطريق إلى الظهور.
أسئلة شائعة عن محركات البحث
إجابات مباشرة على أبرز الأسئلة حول محركات البحث، مصادر معلومات Google، مراحل عمله، ومحركات البحث المعتمدة على الذكاء الاصطناعي.
ما هي أهم 4 محركات بحث؟
أهم 4 محركات بحث عالميًا من حيث الاستخدام هي Google وBing وYahoo وYandex . ويظل Google الأكثر استخدامًا عالميًا بفارق كبير، بينما يأتي Bing كأحد أبرز المنافسين، وتختلف شعبية باقي المحركات حسب الدولة، نوع الجهاز والجمهور المستخدم.
من أين يحصل جوجل على المعلومات؟
يحصل Google على المعلومات أساسًا من صفحات الويب التي يكتشفها عبر الروابط وملفات Sitemap ، ثم يزحف إليها باستخدام برامج مثل Googlebot، ويحلل النصوص والصور والفيديو والعناصر المهمة قبل تخزين المعلومات المناسبة داخل فهرس Google.
ما هي مراحل عمل محرك البحث جوجل؟
يعمل Google عبر ثلاث مراحل رئيسية: الزحف Crawling، الفهرسة Indexing، ثم عرض نتائج البحث Serving Search Results . وخلال هذه الرحلة توجد عمليات أخرى تساعده على فهم الصفحة مثل اكتشاف URL، معالجة المحتوى Rendering، واختيار النسخة الأساسية Canonical قبل تحديد الصفحات المناسبة للظهور في البحث.
ما هي أفضل 10 محركات في العالم؟
لا يوجد ترتيب ثابت يحدد أفضل محركات البحث لكل المستخدمين، لأن الاختيار يختلف حسب الدولة والخصوصية ونوع البحث. ومن أبرز 10 محركات بحث عالميًا: Google، Bing، Yahoo، Yandex، DuckDuckGo، Baidu، Naver، Brave Search، Startpage وEcosia .
ما هي محركات بحث الذكاء الاصطناعي؟
محركات بحث الذكاء الاصطناعي هي أدوات تجمع بين البحث في الويب ونماذج الذكاء الاصطناعي لفهم السؤال، البحث عن المعلومات، تلخيصها وتقديم إجابة مباشرة مع مصادر أو روابط داعمة. ومن أبرز الأمثلة Google AI Mode وAI Overviews، Microsoft Bing Copilot Search، Perplexity وChatGPT Search .
كيف تعمل محركات البحث وما الذي يجب أن تتذكره؟
فهم كيف تعمل محركات البحث يمنحك صورة أوضح عن رحلة الصفحة منذ لحظة اكتشافها وحتى ظهورها أمام المستخدم في نتائج البحث. فالصفحة لا تنتقل مباشرة إلى Google، بل تمر بعدة مراحل تشمل الاكتشاف، الزحف، معالجة المحتوى، الفهرسة، اختيار النسخة الأساسية، ثم تقييم مدى ملاءمتها وترتيبها عند تنفيذ عملية البحث.
وهذا يوضح أيضًا أن وجود الصفحة على الإنترنت لا يكفي وحده، كما أن الزحف إليها لا يضمن فهرستها، والفهرسة لا تعني بالضرورة حصولها على ترتيب متقدم. كل مرحلة تعتمد على مجموعة مختلفة من العوامل التقنية، والمحتوى والإشارات التي تساعد محرك البحث على فهم الصفحة واختيار الوقت والاستعلام المناسبين لعرضها.
لذلك، إذا كنت تعمل على SEO، فالأفضل ألا تنظر إلى الترتيب باعتباره خطوة منفصلة، بل كنتيجة لرحلة كاملة تبدأ من جعل الصفحة قابلة للاكتشاف والوصول، ثم تقديم محتوى واضح ومفيد يمكن لمحركات البحث فهمه والمستخدم الاستفادة منه.
ومع تطور البحث وظهور تجارب مثل AI Overviews وAI Mode، يظل الأساس نفسه مهمًا: محتوى يمكن اكتشافه، الوصول إليه، فهمه وفهرسته بصورة صحيحة. وهذا هو الأساس الذي تُبنى عليه فرص الظهور، سواء في نتائج البحث التقليدية أو تجارب البحث المعتمدة على الذكاء الاصطناعي.
ظهور الصفحة في نتائج البحث ليس حدثًا منفصلًا، بل نتيجة سلسلة مترابطة تبدأ من الاكتشاف والزحف وتمر بـ الفهم والفهرسة وتنتهي باختيار الصفحة وترتيبها عندما تكون مناسبة لعملية البحث التي يجريها المستخدم.